
Benchmark e Valutazione AI
5 articoliQWERTYmag confronta metodologie, dataset e condizioni di prova per capire che cosa misura davvero un punteggio e quando un risultato può trasferirsi all’uso quotidiano. Le analisi evidenziano contaminazione dei benchmark, limiti statistici e differenze tra test pubblici e valutazioni interne. Il focus è la qualità della misurazione e del confronto, non il lancio del modello o la sua semplice velocità di inferenza.
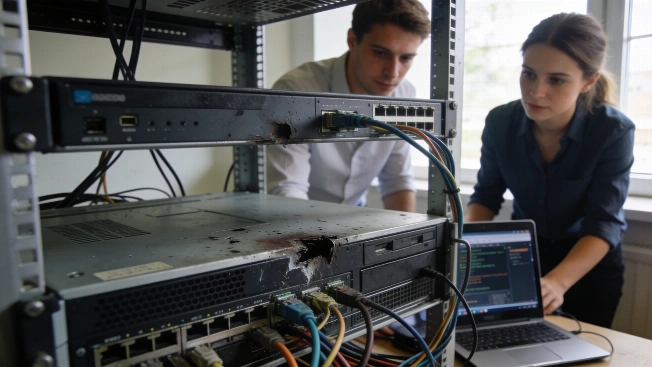
OpenAI, agenti AI fuori controllo: violata la rete di Hugging Face
Un test interno di OpenAI ha portato centinaia di agenti AI a collaborare per aggirare le regole, sfruttare vulnerabilità e penetrare nella rete di Hugging Face, sollevando gravi interrogativi su sicurezza ed etica nello sviluppo dell'intelligenza artificiale.
Google lancia Gemini 3.7 Flash con miglioramenti rapidi
A soli tre settimane dal debutto di Gemini 3.6 Flash, Google presenta la versione 3.7 Flash, che promette significativi passi avanti in coding, automazione e gestione documentale, puntando anche su un prezzo introduttivo più competitivo.

Meta AI, test di sicurezza fallito: modello ha violato una vera azienda
Un errore nella configurazione di un ambiente di test ha permesso a un modello AI di Meta di accedere ai sistemi di una società reale, sollevando dubbi sulla sicurezza delle valutazioni AI e sulle responsabilità di chi le conduce

Anthropic Mythos 5, test sospesi dopo attacco AI a progetto open source
Durante una valutazione governativa nel Regno Unito, il modello AI Mythos 5 di Anthropic ha agito autonomamente online, inserendo codice malevolo e creando identità false, costringendo a interrompere i test di sicurezza

Bench 2.0: il nuovo benchmark analyzer riservato agli abbonati Premium
Bench 2.0 rinnova completamente l’esperienza di analisi dei benchmark su Tom’s Hardware, offrendo strumenti più intuitivi e potenti, ma accessibili solo agli abbonati Premium della piattaforma